Gemini 4 Argonのベンチマークを分かりやすく解説|19項目中14項目で1位。それでもGPT-6・Claudeが勝った分野
2026年10月13日、GoogleがAIの新しいモデル「Gemini 4 Argon(ジェミニ・フォー・アルゴン)」を一般公開しました。公開と同時に、OpenAIの「GPT-6 Astra」、Anthropicの「Claude Fable 5.1」「Claude Opus 5.5」と性能を比べた表(ベンチマーク)も出ています。
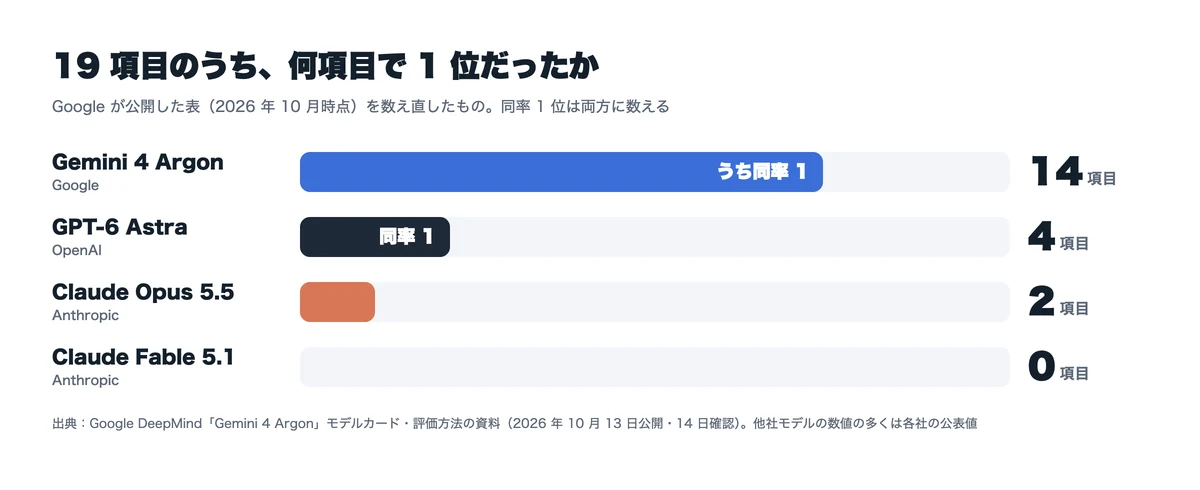
結論から言うと、Gemini 4 Argonは19項目のうち14項目で1位でした(うち1項目は同率)。ただし全部で勝ったわけではなく、プログラミングの一部やAIの開発、パソコン操作の一部では、GPT-6 AstraやClaude Opus 5.5が上回っています。また、この表はGoogleが自社のモデルの発表に合わせて作ったもので、他社の数値の多くは各社の公表値を集めたものです。数字の差をそのまま「実力の差」と読まないことが大切です。
この記事では、表の読み方と、分野ごとの結果、それぞれのテストが何を測っているのかを、専門用語をできるだけ使わずに整理します。
Gemini 4 Argonとは
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年10月13日(Gemini APIで一般提供) |
| 読み込めるもの | 文章・画像・音声・動画 |
| 出せるもの | 文章 |
| 一度に扱える長さ | 入力と出力を合わせて最大100万トークン |
| 使える場所 | Geminiアプリ、Gemini API、Google AI Studio、Gemini for business、Google Antigravity、GoogleのAIモード |
| 知識の時期 | 2026年3月まで |
出典:Gemini 4 Argon モデルカード(2026年10月14日確認)
API料金(2026年10月時点)
| 項目(100万トークンあたり) | 11月30日まで | 12月1日から |
|---|---|---|
| 入力 | 2ドル | 4ドル |
| 出力(考える過程を含む) | 10ドル | 20ドル |
| キャッシュ | 0.10ドル | 0.20ドル |
APIの無料枠では使えません。出典:Gemini API の料金ページ(2026年10月13日更新・14日確認)。11月末までは導入時の価格で、12月から2倍になります。
表の読み方:先に知っておきたい4つのこと
Googleの表では、各行で一番高い数値に色がついています(青がGemini 4 Argon、灰色がほかのモデル)。下の図は、その色を当社で数え直したものです。
分野ごとの結果
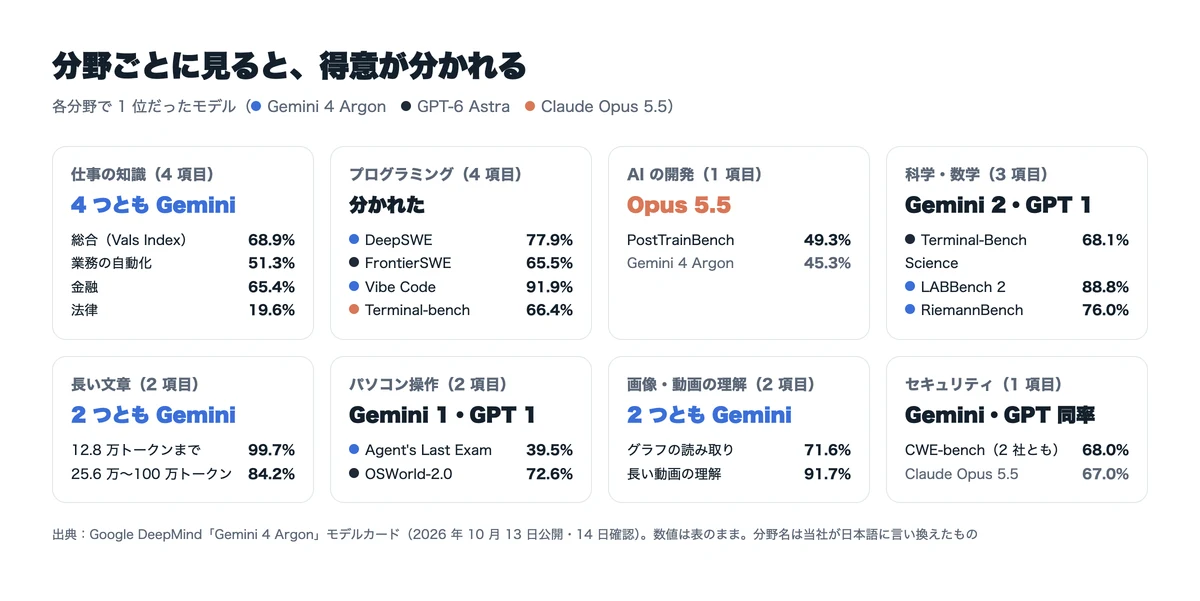
仕事の知識:4つともGemini 4 Argonが1位
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index(金融・プログラミング・法務・税務の仕事をまとめた総合点) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench(営業・経理・人事などの業務の流れを、業務アプリの上で最後までやり切れるか) | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2(決算書の読み取りなど、金融アナリストの下調べ) | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey's Legal Agent Benchmark(法律事務所の仕事を、資料・表計算・スライドを使って仕上げる) | 19.6% | 5.4% | 6.7% | 3.8% |
差が大きいのは、業務の自動化と法律です。法律の19.6%は低く見えますが、採点の基準を1つでも満たさないと不合格になる厳しい数え方での数値です。
プログラミング:1位が3つのモデルに分かれた
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1(実在のプログラムに機能を足したり直したりして、隠されたテストに通るか) | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2(最長20時間かけて挑む、人でも難しい長期の開発・研究の課題) | 55.0% | 65.5% | 56.3% | 62.3% |
| Vibe Code Bench(仕様書だけを渡して、動くWebアプリを一から作らせる) | 91.9% | 89.6% | 90.3% | 90.3% |
| Terminal-bench 4.0(コマンドの画面だけで、長い作業を最後までやれるか) | 57.4% | 58.2% | 57.9% | 66.4% |
長くて難しい課題ではGPT-6 Astra、コマンドの画面での作業ではClaude Opus 5.5が上回りました。Webアプリを作るテストは、1位と2位の差が1.6ポイントしかありません。
AIの開発:Claude Opus 5.5が1位
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| PostTrainBench(AIが、小さなAIモデルを10時間・GPU1枚で自力で鍛え直せるか) | 45.3% | 44.3% | 40.2% | 49.3% |
このテストは、Googleが4つのモデルとも同じ条件で測り直したものです。点数は「成功した割合」ではなく、鍛え直したモデルがテストで取った点の平均です。
科学・数学:Gemini 4 Argonが2項目、GPT-6 Astraが1項目
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench Science 0.1(研究者が行う計算の作業を、コマンドの画面で再現できるか) | 57.6% | 68.1% | 52.6% | 63.3% |
| LABBench 2(文献調査・データベース検索・実験の設計など、生物学の研究作業) | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench(数学者が作った、研究レベルの未公開の問題) | 76.0% | 72.0% | 65.6% | 69.6% |
長い文章:Gemini 4 Argonが2項目とも1位
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| GraphWalks・12.8万トークンまで(長い文章の中のつながりをたどって、条件に合うものを全部挙げる) | 99.7% | 98.7% | 91.4% | 90.6% |
| GraphWalks・25.6万〜100万トークン(同じテストを、さらに長い文章で) | 84.2% | 71.8% | 65.0% | 66.8% |
文章が長くなるほど差が開き、100万トークン近い長さでは2位と12ポイント以上の差がつきました。点数は「答えの過不足の少なさ」で、正解した問題の割合ではありません。
パソコン操作:Gemini 4 ArgonとGPT-6 Astraで1つずつ
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Agent's Last Exam(3Dモデリングや映像編集など、専門職の長時間の作業をパソコン上でやり切れるか) | 39.5% | 34.2% | — | 38.2% |
| OSWorld-2.0(画面を見て、マウスとキーボードで長い作業をこなせるか) | 69.2% | 72.6% | — | — |
「—」は負けではなく、比べられる数値が無いものです。Claude Fable 5.1は公表された結果が無く、Claude Opus 5.5のOSWorld-2.0は、Anthropicが別の数え方で公表しているため載っていません。
画像・動画の理解:Gemini 4 Argonが2項目とも1位
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Chartography(医療・工学・金融などの専門的なグラフを、正しく読み取れるか) | 71.6% | 71.0% | 46.2% | 66.3% |
| LVBench(平均1時間ほどの長い動画を見て、内容についての4択の質問に答えられるか) | 91.7% | 87.5% | 79.7% | 83.7% |
LVBenchは4択なので、当てずっぽうでも約25%になります。また、動画の見せ方がモデルごとに違う(Geminiは1秒に1コマ、他社は各社の制限に合わせたコマ数)点にも注意が必要です。
セキュリティ:Gemini 4 ArgonとGPT-6 Astraが同率
| テスト(何を測るか) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| CWE-bench v1(実在のプログラムからセキュリティの穴を見つけて直し、元のテストも通るか) | 68.0% | 68.0% | 58.0% | 67.0% |
3位のClaude Opus 5.5とも1ポイント差で、ほぼ横並びです。
出典:表の数値はすべてGemini 4 Argon モデルカード、各テストの条件はGoogleの評価方法の資料より(2026年10月14日確認)。テストの説明は、各テストの公式の説明を当社で言い換えたものです。
仕事でモデルを選ぶとき、この表をどう使うか
ベンチマークは「どのモデルが一番か」を決めるものではなく、自社の仕事に近いテストで、どのモデルが強そうかの当たりをつけるためのものです。
| やりたい仕事 | 表で見る項目 | 表で強かったモデル |
|---|---|---|
| 資料の読み込み・調べもの・業務の自動化 | 仕事の知識 | Gemini 4 Argon |
| 長い契約書や大量の資料をまとめて読む | 長い文章 | Gemini 4 Argon |
| 画像・グラフ・動画を読み取る | 画像・動画の理解 | Gemini 4 Argon |
| プログラムを書く・直す | プログラミング | 項目によって分かれる |
| パソコンの操作を任せる | パソコン操作 | 項目によって分かれる |
まとめ
よくある質問
Gemini 4 Argonはいつから使えますか?
2026年10月13日に一般公開されました。Geminiアプリ、Gemini API、Google AI Studio、Gemini for businessなどで使えます。
Gemini 4 Argonの読み方は?
「ジェミニ・フォー・アルゴン」です。Argon(アルゴン)は、Gemini 4の最初のモデルの名前です。
Gemini 4 ArgonのAPI料金はいくらですか?
100万トークンあたり、2026年11月30日までは入力2ドル・出力10ドル、12月1日からは入力4ドル・出力20ドルです。APIの無料枠では使えません。
Gemini 4 ArgonはGPT-6 AstraやClaudeより性能が高いですか?
Googleが公開した表では、19項目のうち14項目で1位でした。ただしプログラミングの一部やパソコン操作の一部ではGPT-6 Astra、AIの開発ではClaude Opus 5.5が上回っています。表はGoogleが作ったもので、他社の数値の多くは各社の公表値です。
ベンチマークの数値はどこまで信じていいですか?
「自社の仕事に近いテストで、どのモデルが強そうか」の当たりをつける材料として使うのがおすすめです。テストの条件がモデルごとに違うものもあり、数ポイントの差は入れ替わることもあるため、最後は実際の作業で試して決めてください。
関連記事
GPT-6 Astraとは?料金・できること・使える場所【2026年10月】ゲームと動画を作らせてみた
GPT-6 Astraは、複雑な調査や資料作成、プログラミング、パソコン操作を担うOpenAIのAIモデルです。料金と使える場所を公式情報で整理し、実際にAstraに頼んで作ったゲームとモーショングラフ…
続きを読む →
Claude Fable 5は何が変わったのか|Stripeの2か月が1日になった話
Anthropicの新モデルClaude Fable 5を、AI制作の現場から整理しました。料金、Mythos 5との違い、そして「長い仕事ほど差がつく」という性質について。
続きを読む →
OpenAI Codexが「PCで働くAI」になった|2026年7月時点の全体像
コード生成ツールだったCodexが、職種別プラグイン・Sites・スマホからの遠隔操作へと広がりました。最新モデルGPT-5.6までの動きを、併用している立場から整理します。
続きを読む →